
Melakukan uji statistik adalah salah satu tugas utama seorang data scientist. Salah satu uji statistik yang sering dilakukan adalah U-Test. U-Test banyak digunakan karena seringkali hasil eksperimen tidak memenuhi asumsi distribusi normal, dan U-test valid untuk dilakukan di dalam situasi tersebut. U-test sering dilakukan dengan software SPSS, namun bisa juga dilakukan dengan Python lho.
Dalam tutorial ini akan dijelaskan bagaimana melakukan U-Test, tepatnya Mann Whitney U-Test dengan Python.
Pembahasan tutorial ini mencakup:
- Cara Import dummy dataset
- Visualisasi histogram (normal distribution test)
- Mann Whitney U-test
- Menghitung mean dan standard deviasi
Tentang Mann Whitney U-Test
Mann Whitney U-Test adalah uji non parametrik yang digunakan untuk mengetahui perbedaan median dari dua kelompok bebas apabila skala data variabel terikatnya adalah ordinal atau interval/ratio, akan tetapi datanya tidak berdistribusi normal.
Dengan demikian, uji Mann Whitney U-Test memiliki syarat bahwa data wajib berskala ordinal, interval atau rasio. Apabila datanya berupa interval atau rasio, maka distribusinya tidak normal. Adapun sumber datanya adalah dua kelompok yang berbeda, misal kelas A dan kelas B, di mana individu atau objek yang diteliti adalah objek yang berbeda satu sama lain.
Import file CSV ke dataset
Pertama kita impor dataset dengan menggunakan library Pandas. Code nya adalah seperti dibawah ini.
import pandas as pd
df = pd.read_csv('Score data.csv')
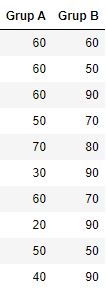
Dengan memasukkan perintah di atas, dataset telah berhasil kita impor. Apabila kita memasukkan perintah df, maka akan muncul seperti dibawah ini.
Visualisasi Histogram (Normal Distribution Test)
Langkah selanjutnya yaitu kita melakukan uji distribusi normal. Kita akan memulai dengan visual assesment. Ini dapat dilakukan dengan visualisasi histogram. Dalam melakukan visual assessment, referensi yang kita gunakan untuk menilai adalah seperti dibawah ini.
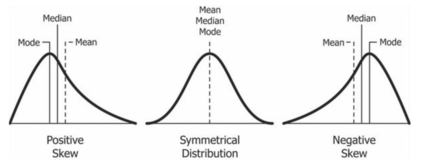
Berdasarkan gambar di atas, dalam melakukan visual assessment, kita dapat menyimpulkan bahwa data memenuhi kriteria normal distribution jika histogram berbentuk seperti gambar yang tengah yaitu symmetrical distribution. Apabila histogram menyerupai dengan bentuk positive skew atau negative skew, maka data tidak memenuhi kriteria normal distribution.
Pertama kita menampilkan histogram score data dari Grup A. Caranya adalah seperti dibawah ini.
import matplotlib.pyplot as plt
plt.hist(df['Grup A'])
plt.grid()
Tujuan dari code di atas adalah untuk mengimpor library Matplotlib.pylot kemudian menggunakannya untuk membuat histogram dari data Grup A. Hasilnya adalah seperti dibawah ini.
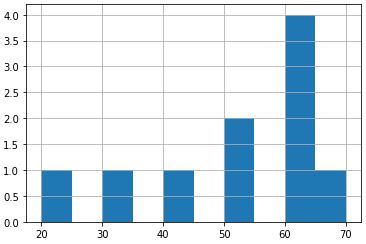
Dari histogram diatas, kita dapat menyimpulkan bahwa histogram memiliki struktur negative skew, yang artinya histogram tersebut tidak memenuhi syarat normal distribution. Hal tersebut membuatnya layak untuk dianalisis dengan Mann Whitney U-test.
Selanjutnya adalah menampilkan histogram Grup B. Caranya sama seperti sebelumnya, yaitu:
plt.hist(df['Grup B'])
plt.grid()
Code di atas akan menghasilkan output seperti di bawah ini.
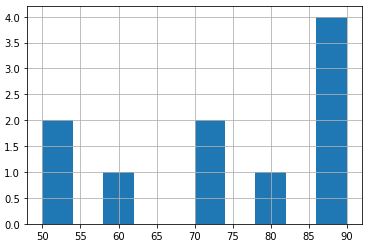
Berdasarkan histogram Grup B yang dihasilkan, menunjukkan bahwa strukturnya adalah negative skew, yang artinya histogram tersebut tidak memenuhi syarat distribusi normal. Fakta ini juga mendukung untuk melanjutkan analisis data dengan Mann Whitney U-test.
Mann Whitney U-Test di Python
Setelah melakukan uji distribusi normal, dan membuktikan bahwa data tidak memenuhi syarat distribusi normal, selanjutnya kita masuk ke dalam Mann Whitney U-test. Dalam Python, untuk melakukan uji ini caranya cukup sederhana yaitu seperti di bawah ini.
from scipy.stats import mannwhitneyu
U1, p = mannwhitneyu(df['Grup A'], df['Grup B'])
print(p)
Tujuan dari perintah di atas adalah kita mengimpor library Mannwhitneyu, kemudian menggunakannya untuk melakukan uji antara Grup A dan Grup B. Hasil perintah di atas akan memunculkan output sebagai berikut.
0.010014752493714267Berdasarkan output di atas, kita mendapatkan nilai 0.01 untuk p-value. Apa artinya? Artinya bahwa ditemukan perbedaan yang signifikan di antara kedua grup, dimana syarat dinyatakan adanya perbedaan signifikan adalah p<0.05. Hal ini merupakan hasil yang diharapkan dalam penelitian dimana kita mendapatkan bukti yang valid untuk menolak Ho.
Selanjutnya, seringkali juga dibutuhkan mean dan standard deviasi untuk keperluan penulisan penelitian. Hal itu juga dapat dipenuhi dengan Python dengan cara seperti di bawah ini.
df['Grup A'].mean()
50.0
df['Grup B'].mean()
74.0Perintah di atas adalah cara mendapatkan nilai mean dari setiap group. Dari hasil di atas, kita bisa simpulkan bahwa mean untuk Grup A adalah 50 dan Grup B adalah 74. Kemudian untuk standard deviasi, caranya seperti di bawah ini.
import statistics
statistics.stdev(df['Grup A'])
15.634719199411432
statistics.stdev(df['Grup B'])
16.46545204697129Untuk menentukan nilai deviasi standard, kita membutuhkan library Statistics. Dari perhitungan kita mendapatkan output yaitu 15.634 untuk Grup A, dan 16.465 untuk Grup B.
Apabila kita gabungkan hasil di atas ke dalam satu tabel maka akan menjadi seperti tabel dibawah ini.
| Group | N | Mean | Std. dev | P-value |
| Group A | 10 | 50 | 15.63 | 0.01 |
| Group B | 10 | 47 | 16.46 |
Code dan file dataset yang digunakan dalam tutorial ini bisa di download di tautan berikut:
Demikian materi Tutorial Mann Whitney U-test dengan Python. Semoga bermanfaat.


